Introducción
En los posts anteriores presenté Sentry y sus componentes. Este es el resumen de lo que ha pasado desde entonces, y no es una lista de features sino de problemas reales que encontré al verificar contra producción: un modelo de lenguaje que no llegaba a donde debía, un pipeline que dejaba sin texto de respaldo a todo el dataset sin avisar y un reporte ejecutivo que mostraba números que parecían correctos y no lo eran.
Hay dos hilos:
- Enriquecimiento con IA local sin abrir ni un puerto: Ollama corre en mi red, Sentry corre en Azure, y se hablan por una cola.
- Executive Report: revisarlo como lo revisaría un stakeholder y corregir cada cosa que no resistía una pregunta.
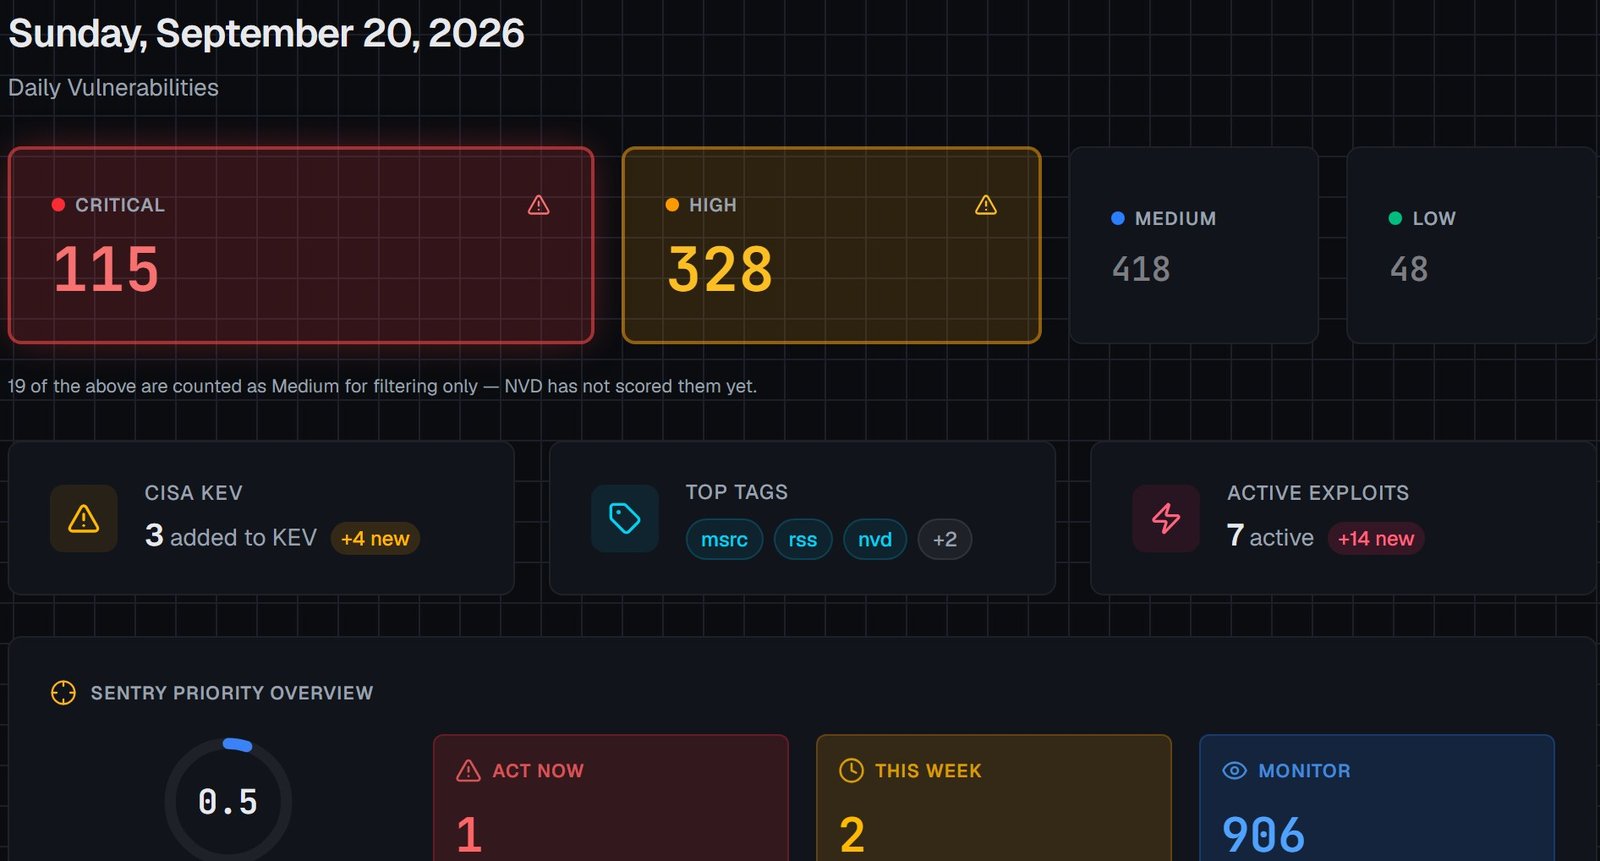
El dashboard diario: severidad, CISA KEV, exploits activos y el Sentry Priority Overview.
Parte 1: IA local sin exponer nada
El problema
Quería que Sentry explicara cada amenaza en lenguaje claro usando un modelo que corre en mi propio equipo (Ollama), sin mandar datos a un tercero. El obstáculo es simple: Sentry vive en un Azure App Service y Ollama vive detrás de un NAT. La primera configuración apuntaba a http://localhost:11434, y localhost dentro del contenedor es el contenedor, no mi máquina. Cero conexión, cero error visible: el pipeline caía al texto de plantilla y nadie se enteraba.
La solución: una cola como puente
En lugar de abrir un túnel o una ruta entrante, invertí la dirección. El pipeline escribe solicitudes en una Azure Storage Queue y un worker, que corre donde está Ollama, las lee, llama al modelo local y escribe la respuesta en otra cola. El worker sale hacia Azure; nada entra a mi red.
El contrato es deliberadamente mínimo:
Una decisión de diseño importante: no es una llamada por amenaza. Con más de 1900 amenazas y unos 15 segundos por respuesta en hardware local, esperar una por una tomaría horas. El pipeline envía un lote priorizado (primero las de CISA KEV, luego por CVSS, con un tope de 60), espera una sola vez un tiempo total acotado y lo que no llega a tiempo conserva el texto de plantilla.
Lo que salió mal, en orden de aparición
1. Una regresión que existía desde antes. Al revisar el resultado completo (no una muestra de dos o tres amenazas) encontré que 0 de 1921 amenazas tenían resumen. La causa estaba en main.py: si había cualquier proveedor de LLM configurado, el resumidor de plantilla no corría nunca, aunque el LLM no respondiera. Lo arreglé invirtiendo el orden: primero la plantilla para todo, después el LLM como capa aditiva. Tras el arreglo, 1921 de 1921 volvieron a tener contenido.
2. Un worker que consumía mensajes y no contestaba. Las colas se vaciaban pero los resultados no llegaban. La pista fue un mensaje con dequeueCount: 69: el worker lo tomaba, fallaba y lo volvía a tomar en bucle. El worker esperaba job["description"] y el pipeline manda job["prompt"], y además respondía con result en vez de content. Un esquema distinto en cada extremo y ningún error a la vista.
3. Un timeout calculado a ojo. Con 240 segundos, solo 20 de 65 amenazas recibieron contenido real. Subirlo a 900 fue una decisión medida: con el timeout nuevo, las 60 amenazas enviadas volvieron con respuesta del modelo.
| Configuración | Amenazas con texto del modelo |
|---|---|
| Timeout 240 s | 20 de 65 |
| Timeout 900 s | 60 de 60 enviadas |
Verificar lo que realmente cargó el contenedor
Un patrón que repetí varias veces: az webapp config appsettings list te dice lo que Azure quiere inyectar, no lo que el proceso cargó. Agregué un endpoint autenticado, /api/debug/runtime-config, que devuelve el valor real de LLM_PROVIDER y solo booleanos para lo sensible (por ejemplo, si la cadena de conexión existe, nunca su valor). Fue lo que me permitió confirmar de una vez que el timeout de 900 estaba activo en el contenedor y no solo en el portal.
El modelo también se equivoca
Al pedir más detalle por amenaza, el modelo empezó a inventar datos específicos. Para una vulnerabilidad de Cisco escribió que las versiones anteriores a la 21.11.1 estaban afectadas. Ese número de versión no existía en ningún campo que le pasamos. El texto suena a analista experimentado y eso lo hace más peligroso, no menos.
Mi conclusión práctica: el texto del modelo es narrativa de apoyo, nunca la fuente de un dato técnico. Por eso la plantilla determinista sigue siendo la base y el LLM una capa que se puede apagar sin romper nada. Si el worker está apagado, Sentry sigue funcionando y muestra el texto de plantilla.
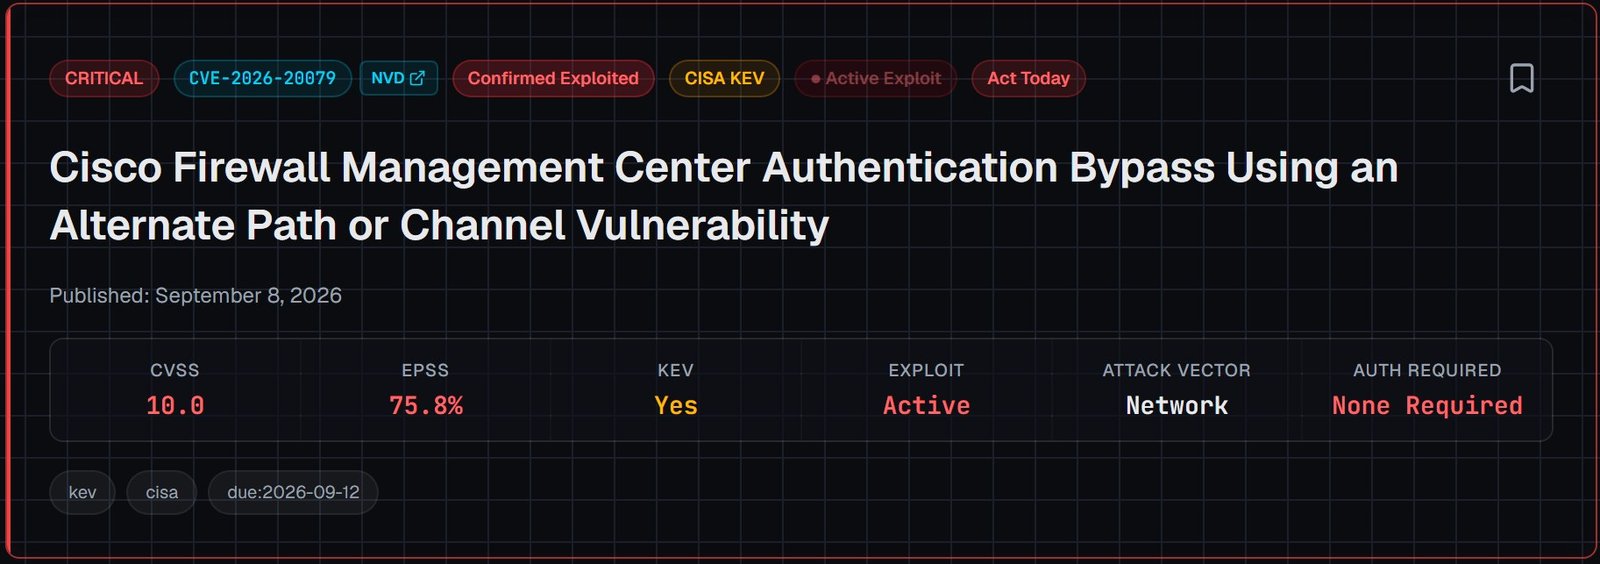
Detalle de una amenaza: CVSS, EPSS, KEV, explotación activa y acción recomendada. El análisis en texto lo genera el modelo local cuando el worker está disponible, o la plantilla cuando no.
Parte 2: un Executive Report que resista preguntas
Revisé el reporte como lo haría alguien que lo va a presentar a un cliente. Cada observación encontró un problema real.
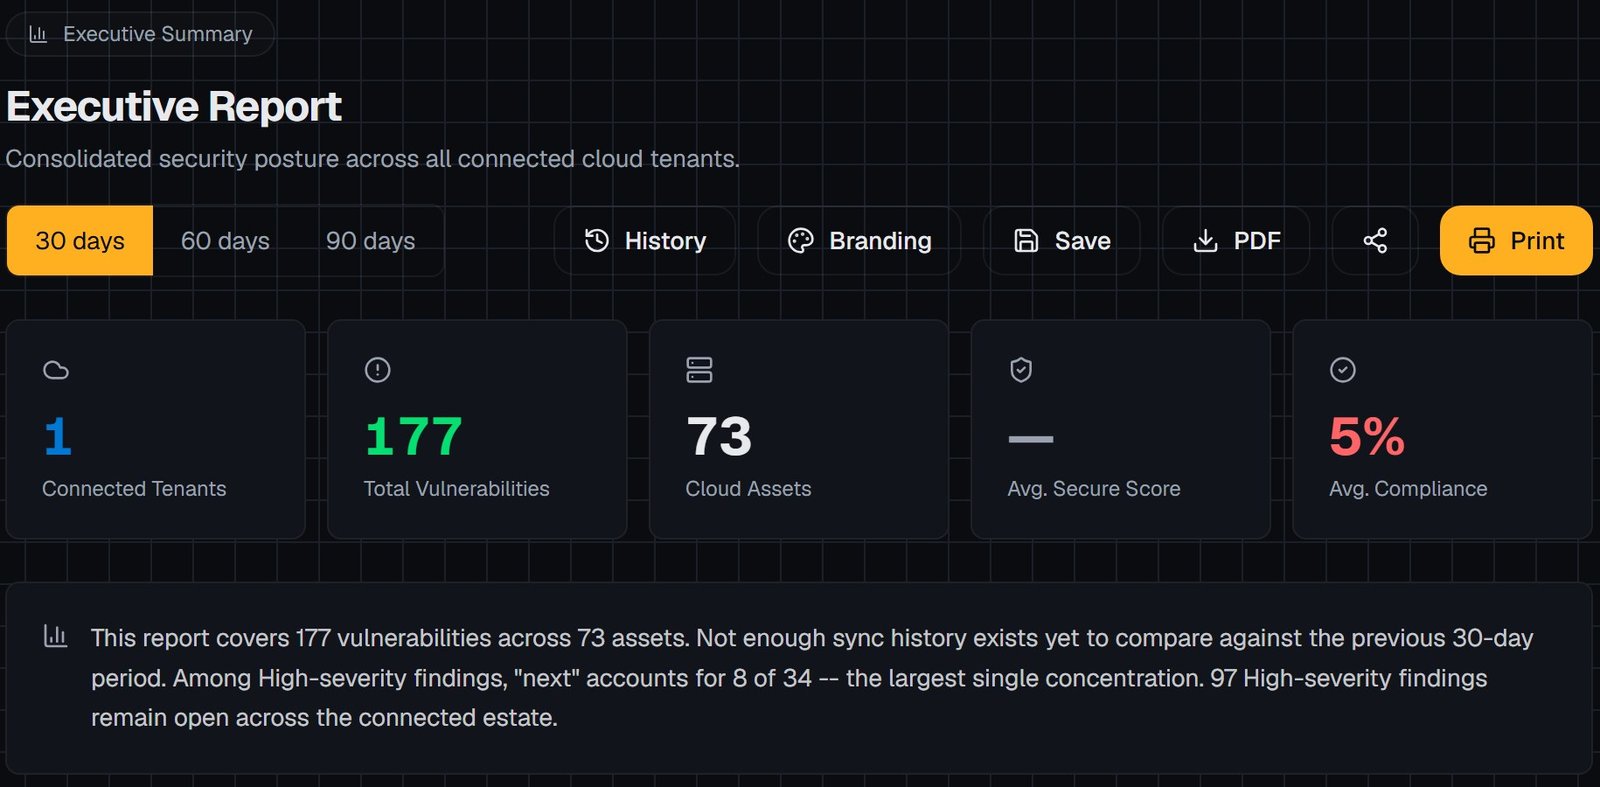
El Executive Report: KPIs, resumen narrativo y acciones de exportación.
| Lo que se veía | Qué estaba pasando | Qué hice |
|---|---|---|
| El mismo CVE repetido 6 u 8 veces | Cada resultado de Defender era una fila, sin agrupar | Agrupar por tenant, asset, CVE y severidad, con contador |
| Tabla solo con severidad High | Un corte de 50 filas ordenado por severidad dejaba fuera todo lo demás | Cupo reservado por severidad y filtros contra el dataset completo |
Asset unknown en todas las filas | Defender for DevOps devuelve ResourceName en PascalCase, el código leía resourceName | Leer ambas variantes: los assets pasaron de 49 a 73 |
| Secure Score en 0% | La API respondía HTTP 431 y un cálculo de respaldo producía 0/177 | Mostrar un guion cuando la llamada falla, sin inventar un número |
| Salto de fechas en la tendencia | No hubo syncs durante 8 días y el eje dibuja una línea recta | Puntos visibles y aviso explícito del hueco |
| Compliance en 5% | Era correcto: 2 de ~41 controles marcados manualmente | Nada que arreglar, solo confirmarlo |
Los dos que más me enseñaron fueron el del asset y el del Secure Score.
El asset: los “duplicados” nunca fueron el mismo hallazgo repetido. Eran la misma vulnerabilidad de npm en repositorios distintos, y el bug de nombres los mezclaba en un asset ficticio. Con el nombre real, cada uno aparece como lo que es.
El Secure Score: un 0% es un número plausible, y por eso es peligroso. Distinguir “Azure no tiene score para reportar” de “la llamada falló” cambia todo. Un guion honesto vale más que un cero fabricado.
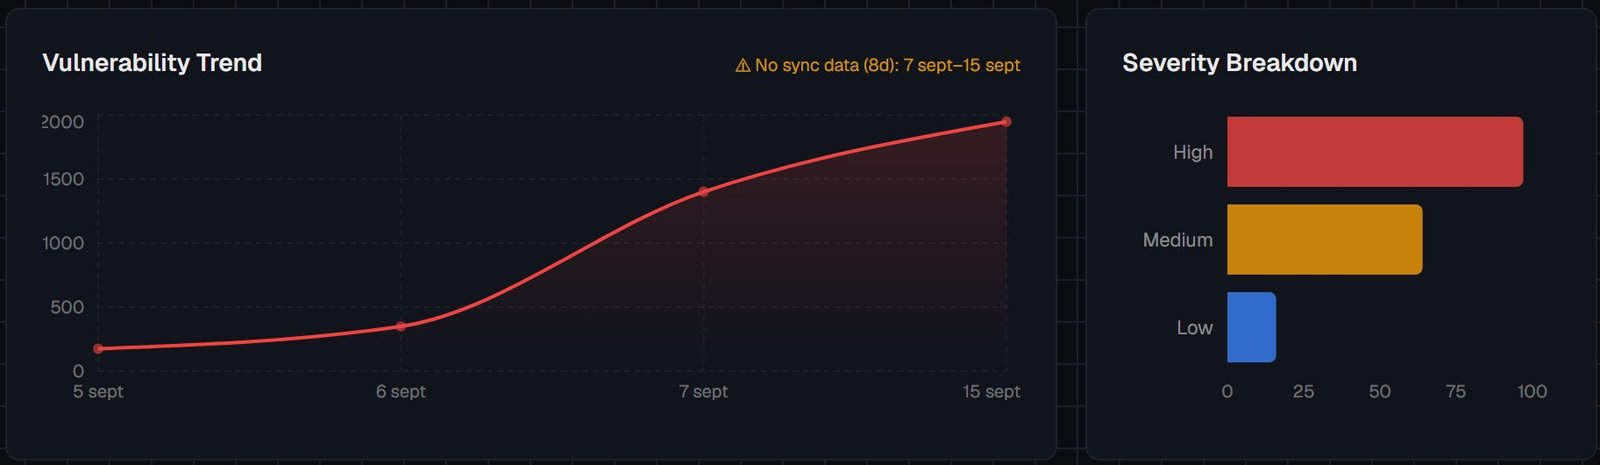
La tendencia ahora avisa cuando faltan datos: 8 días sin sync se leen como hueco, no como una curva suave.
Priorizar con más que una etiqueta
Dos hallazgos “High” no son iguales si uno tiene CVSS 7.5 y otro 9.8. Defender ya traía MaxCvssScore dentro de additionalData, como texto ("8.7"), y simplemente no lo estábamos leyendo. Ahora se muestra y además ordena: dentro de cada severidad, primero el de mayor CVSS.
También agregué antigüedad (desde cuándo está abierto cada hallazgo), dueño y ticket asignables, y criticidad del asset (producción, desarrollo o interno), porque el mismo CVE pesa distinto en un servidor de producción que en un repositorio de pruebas.
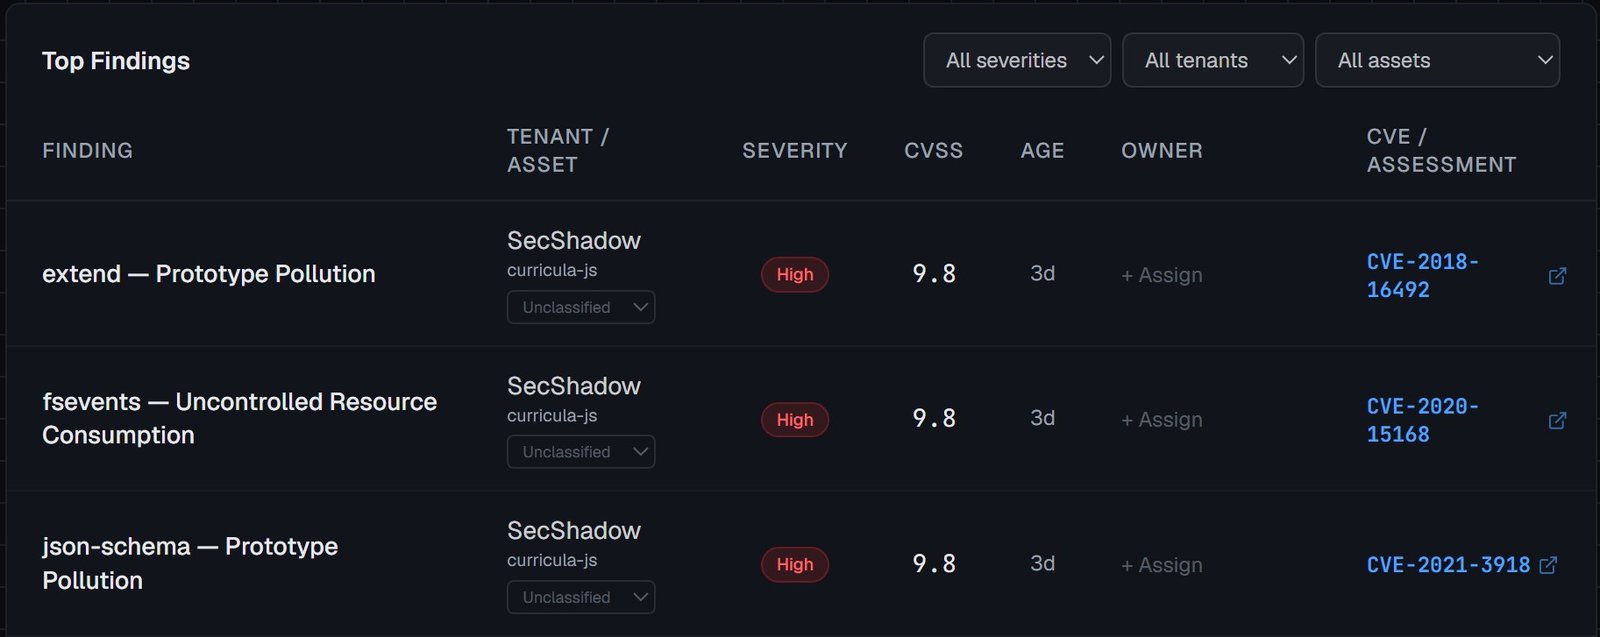
Top Findings: filtros por severidad, tenant y asset; CVSS, antigüedad, dueño y criticidad por asset.
Un resumen narrativo sin LLM, a propósito
El reporte abre con un párrafo que resume la situación. Podría haberlo generado el modelo, y lo descarté: es la última pieza del reporte donde quiero riesgo de invención. Cada frase se construye a partir de valores que ya están en los datos (variación de vulnerabilidades, qué paquete concentra más hallazgos High). Si no hay historial suficiente para comparar con el período anterior, el texto lo dice en lugar de mostrar una variación inventada.
Parte 3: que se pueda entregar
Un reporte que solo se ve en pantalla no es una pieza ejecutiva. Ahora se puede:
- Descargar en PDF real, generado con
@react-pdf/renderer, sin navegador headless ni Chromium en el contenedor. - Compartir por enlace de solo lectura, firmado con HMAC y con vencimiento de 30 días, sin base de datos ni cuenta del destinatario. Un token alterado devuelve 404.
- Guardar snapshots para reabrir el reporte de una fecha anterior tal como estaba.
- Poner marca propia: nombre de empresa y logo aparecen en la impresión, el PDF y el enlace compartido. Útil cuando lo enseñas en un contexto de preventa.
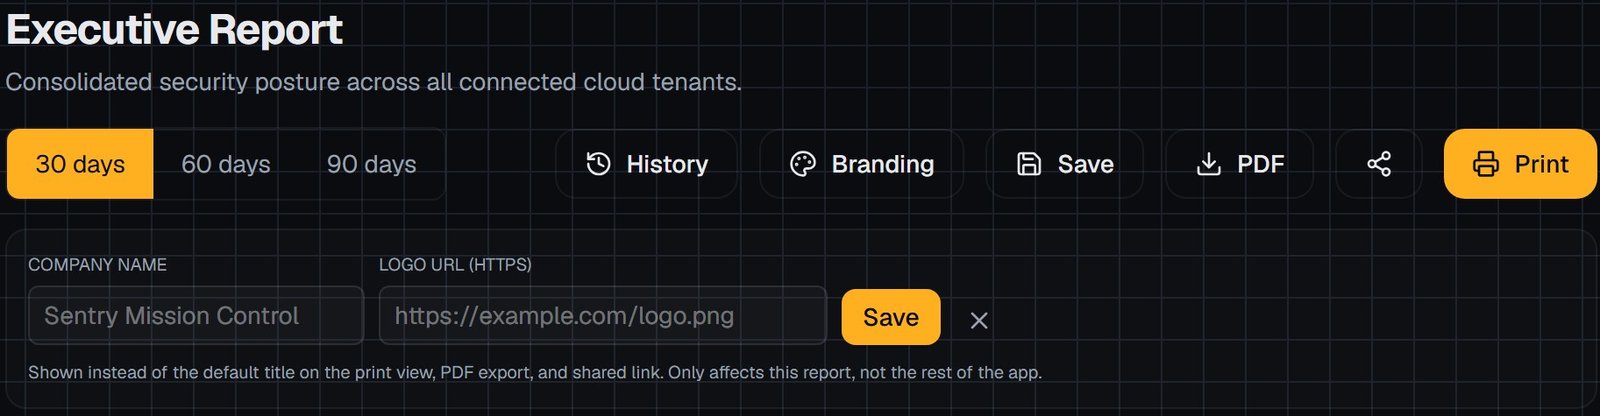
White-labeling: nombre de empresa y logo (URL https) para exportaciones y enlaces compartidos.
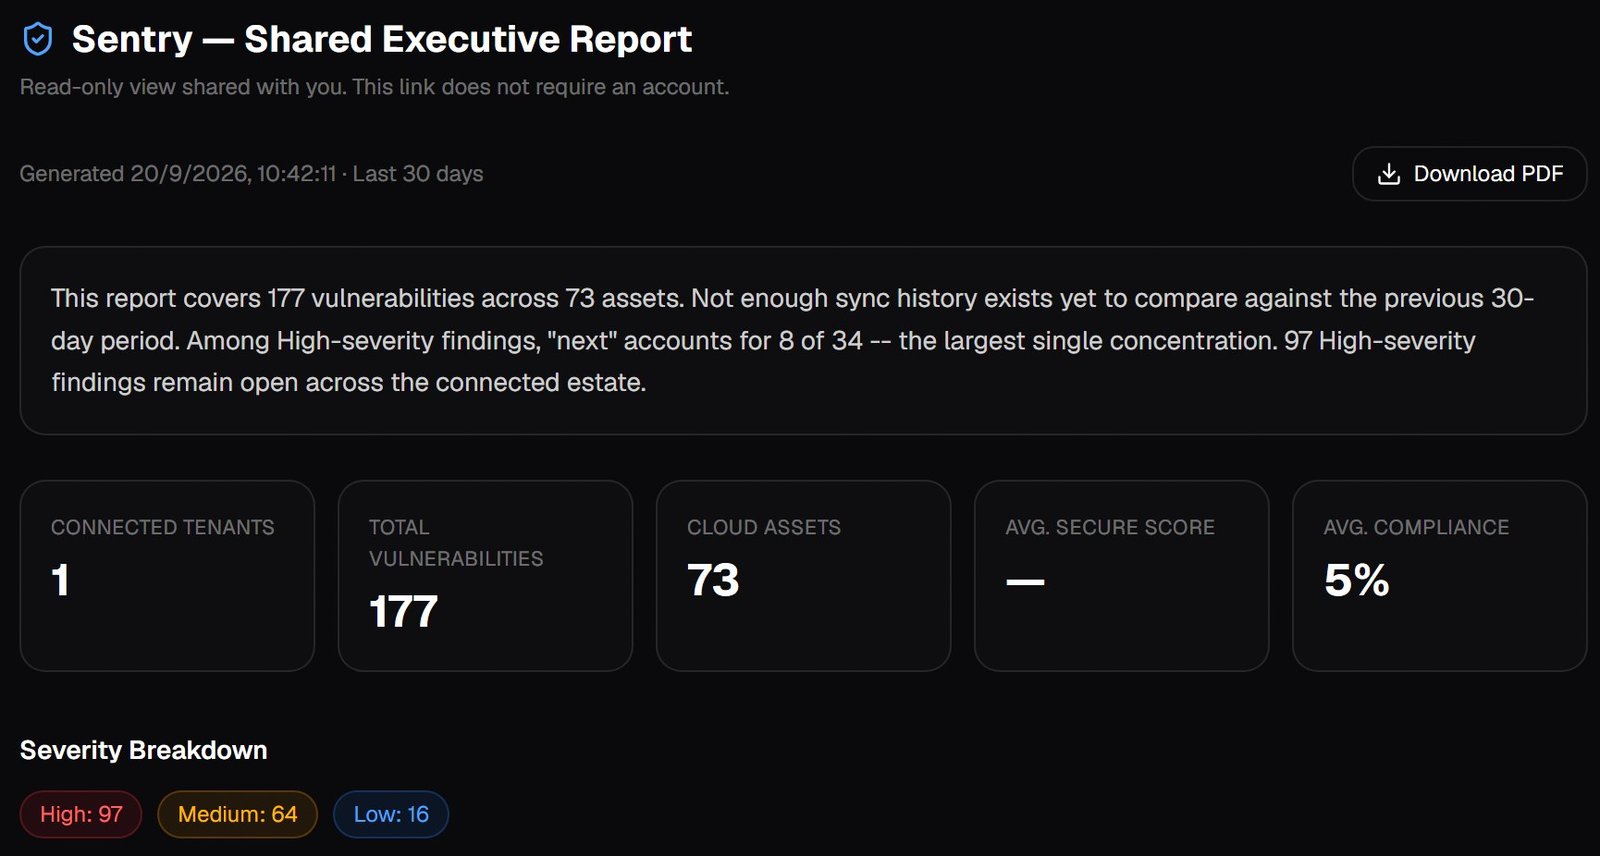
La vista compartida: sin login, con resumen, KPIs y descarga del PDF.
Lecciones
- Verifica contra producción, no contra tu intención. La configuración declarada y el proceso en ejecución pueden no coincidir. Un endpoint que reporta lo cargado ahorra horas.
- Mide el agregado, no una muestra. Dos amenazas con buen aspecto ocultaban 1921 sin contenido.
- Un número plausible y falso es peor que un guion. Distingue “no hay dato” de “falló la llamada”.
- El LLM es una capa, no la base. Si su ausencia rompe el producto, el diseño está mal.
- Mide antes de subir un timeout. El tiempo por elemento manda, no la intuición.
- Cuando el mismo dato aparece “duplicado”, pregunta qué campo los distingue antes de deduplicar a ciegas.
Qué sigue
Con el prompt combinado (resumen, qué pasó y quién se ve afectado en una sola respuesta) el lote tarda unos 25 minutos en vaciarse en lugar de 13, así que con el timeout actual no todo alcanza a volver a tiempo. Mi siguiente paso es decidir entre subir el timeout o bajar el tope de amenazas por corrida. Y la comparación con el período anterior empezará a mostrar valores en cuanto se acumule historial suficiente de snapshots.
Puedes ver la instancia en sentry.d3fend.me o revisar el repositorio en GitHub.